
Implementatie
GovChat-NL kan op verschillende manieren worden geïmplementeerd, zodat het platform aansluit op de wensen en infrastructuur van de organisatie. Er zijn daarbij twee hoofdkeuzes.
Keuze van implementatievorm
Docker-image
- Gebruiksklaar en gemakkelijk te implementeren.
- Ideaal bij standaardinrichtingen met beperkte aanpassingen.
- Beschikbaar als package via deze GitHub-repository.
Via broncode
- Geschikt voor uitgebreide of onverwachte aanpassingen.
- Volledige controle en flexibiliteit.
- Beschikbaar in deze repository.
Keuze van hostingomgeving
Lokale servers
- Volledige controle over data, infrastructuur en beveiliging binnen de eigen organisatie.
Cloudomgeving
- Schaalbaar, flexibel en doorgaans sneller of eenvoudiger te implementeren.
Deze twee keuzes kunnen naar wens worden gecombineerd. Zo kan GovChat-NL bijvoorbeeld als custom-implementatie draaien op lokale servers, of als Docker-image ingezet worden in de cloud. Zo blijft het platform flexibel en altijd af te stemmen op de bestaande IT-voorzieningen en eisen van de organisatie.
Specifieke Implementatie: Provincie Limburg (incl. DPIA)
Een praktijkvoorbeeld van GovChat-NL is de implementatie door de Provincie Limburg. Hierbij wordt gebruikgemaakt van een Docker-image, gehost via Elestio op Hetzner-infrastructuur. De onderliggende taalmodellen draaien in Microsoft Azure (en Google Vertex AI).
Voor deze implementatie is een uitgebreide Data Protection Impact Assessment (DPIA) uitgevoerd. In de DPIA zijn de potentiële risico’s voor privacy en gegevensbescherming in kaart gebracht en zijn de genomen beheersmaatregelen beschreven. Deze DPIA is goedgekeurd en als referentie beschikbaar voor andere overheidsorganisaties die GovChat-NL willen inzetten.
Architectuuroverzicht
Onderstaande diagram laat de relatie en samenwerking tussen de verschillende repositories en systeemonderdelen visueel zien.
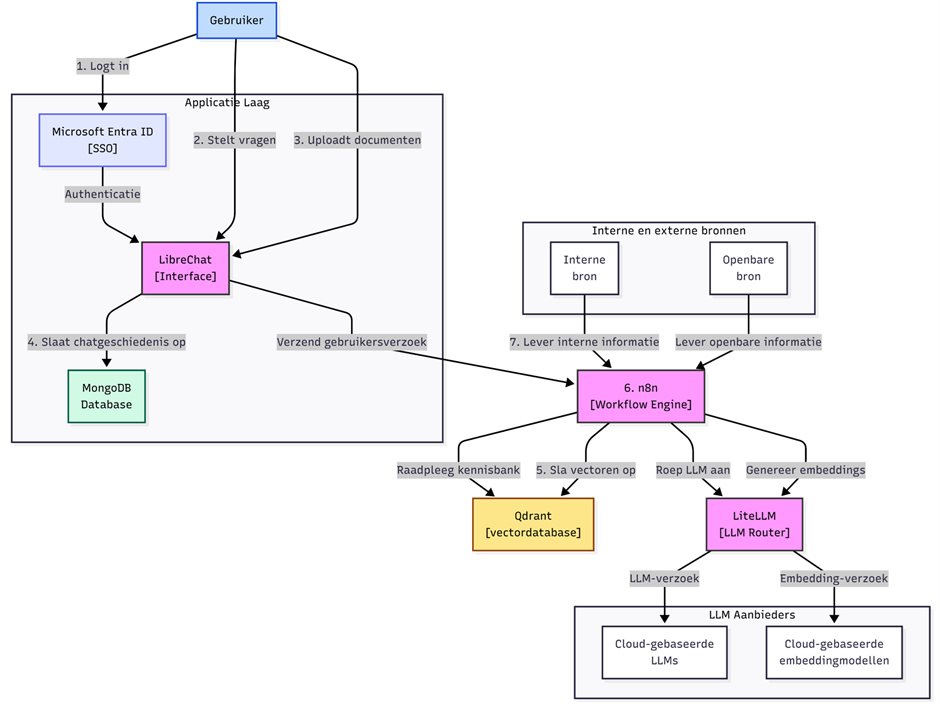
Beschrijvende tekst afbeelding
De afbeelding toont een architectuuroverzicht van een AI-chatoplossing met authenticatie, documentupload, workflow-automatisering, kennisbankfunctionaliteit en koppeling naar zowel taalmodellen als embeddingmodellen. Het schema is opgebouwd van linksboven (gebruiker en applicatielaag) naar rechtsonder (LLM-aanbieders).
Binnen de lichtgrijze zone “Applicatie Laag” bevinden zich de onderdelen waarmee de gebruiker direct interacteert:
-
Microsoft Entra ID [SSO]
Dit onderdeel verzorgt de authenticatie van de gebruiker.
Functie:- Gebruiker logt in via Single Sign-On.
- De identiteit van de gebruiker wordt gecontroleerd voordat toegang wordt verleend.
-
Functionaliteit:
LibreChat [Interface]
Dit is de chatinterface waarin:- Gebruikers vragen stellen.
- Gebruikers documenten kunnen uploaden.
- Verzoeken worden doorgestuurd naar de workflowlaag.
- Chatgeschiedenis wordt beheerd.
- Ontvangt authenticatie vanuit Microsoft Entra ID.
- Verwerkt gebruikersvragen en documentuploads.
- Slaat chatgeschiedenis op in MongoDB.
- Verzendt gebruikersverzoeken naar n8n.
-
MongoDB Database
Deze database wordt gebruikt voor:- Opslag van chatgeschiedenis.
- Mogelijk ook opslag van sessie- of gesprekgerelateerde gegevens.
n8n [Workflow Engine]
n8n functioneert als centrale orkestratielaag tussen de gebruikersinterface, databronnen, vectoropslag en taalmodellen.
- Ontvangt gebruikersverzoeken vanuit LibreChat
- Verwerkt informatie uit interne en openbare bronnen
- Slaat vectoren op in Qdrant
- Raadpleegt de kennisbank / vectordatabase
- Roept LiteLLM aan voor LLM-verzoeken
- Start embedding-verzoeken voor document- of kennisverwerking
n8n is in dit schema duidelijk de centrale regiecomponent die alle onderliggende functies aanstuurt.
In de aparte zone “Interne en externe bronnen” bevinden zich:
- Interne bron
- Openbare bron
- Interne informatie
- Publiek beschikbare informatie
- Contextverrijking voor beantwoording van vragen
- Bronmateriaal voor document- of kennisbankverwerking
Het schema laat zien dat zowel interne als openbare informatie in de workflow kan worden betrokken.
Qdrant [vectordatabase]
Qdrant wordt gebruikt als vectordatabase en vormt de basis voor semantisch zoeken en retrieval.
- Opslag van vectoren
- Raadplegen van de kennisbank
- Ondersteuning van retrieval-augmented generation (RAG)-achtige toepassingen
- Zoeken op betekenis in plaats van alleen op letterlijke tekst
LiteLLM [LLM Router]
LiteLLM ontvangt verzoeken vanuit n8n en routeert deze naar geschikte modelaanbieders.
- Ontvangt LLM-verzoeken van n8n
- Ontvangt embedding-verzoeken van n8n
- Routeert naar passende modellen of aanbieders
- Maakt centrale aansturing van meerdere modellen mogelijk
LiteLLM fungeert hier dus niet alleen als router voor chat- of generatieverzoeken, maar ook voor embeddinggeneratie.
Onder de zone “LLM Aanbieders” worden twee typen modeldiensten onderscheiden:
-
Cloud-gebaseerde LLM’s
Hier vindt de daadwerkelijke taalverwerking plaats:- Vraag beantwoorden
- Tekst genereren
- Samenvatten
- Interpreteren van context
-
Cloud-gebaseerde embeddingmodellen
Deze modellen worden gebruikt om tekst om te zetten in vectorrepresentaties voor:- Documentindexatie
- Semantisch zoeken
- Kennisbankopbouw
Gehele proces in stappen
- Gebruiker logt in via Microsoft Entra ID (SSO).
- Gebruiker stelt een vraag of uploadt documenten in LibreChat.
- LibreChat verwerkt de interactie en stuurt het gebruikersverzoek naar n8n.
- LibreChat slaat de chatgeschiedenis op in MongoDB.
- n8n kan vectoren laten opslaan in Qdrant of bestaande kennisbankinformatie raadplegen.
- n8n roept LiteLLM aan voor een LLM-verzoek of embedding-verzoek.
- n8n kan daarnaast aanvullende informatie ophalen uit interne en openbare bronnen.
- LiteLLM routeert het verzoek naar cloud-gebaseerde LLM’s of embeddingmodellen.
- De opgehaalde of gegenereerde informatie wordt via n8n teruggekoppeld naar de chatinterface.
- De gebruiker ontvangt het antwoord in LibreChat.
Kernkarakter van de architectuur
- Modulair opgebouwd
- Centrale orkestratie via n8n
- Authenticatie geïntegreerd via Microsoft Entra ID
- Chatinterface gescheiden van workflowlogica
- Ondersteuning voor documentverwerking
- Kennisbankfunctionaliteit via Qdrant
- Model-onafhankelijkheid via LiteLLM
- Ondersteuning voor zowel generatie als embeddings
- Geschikt voor verrijking met interne en openbare bronnen
Deze architectuur is daarmee ingericht als een uitbreidbare AI-chatoplossing waarin niet alleen conversatie plaatsvindt, maar ook documentverwerking, kennisbankopbouw en semantisch zoeken een belangrijke rol spelen.
Belangrijkste componenten nader toegelicht
Microsoft Entra ID
Microsoft Entra ID verzorgt de gebruikersauthenticatie via SSO. Dit maakt het mogelijk om bestaande organisatie-identiteiten te gebruiken en centrale toegangscontrole toe te passen.
LibreChat
LibreChat vormt de gebruikersinterface van de oplossing. Hier komen de chatinteractie, documentupload en presentatie van antwoorden samen. Het is de voorkant van het systeem voor eindgebruikers.
MongoDB
MongoDB wordt gebruikt voor het opslaan van chatgeschiedenis. Dit ondersteunt continuïteit van gesprekken en mogelijk ook logging of gebruikerssessies.
n8n
n8n is de workflow-engine en het centrale coördinatiepunt. Hier worden logische stappen uitgevoerd, zoals het ophalen van bronnen, aanroepen van modellen en verwerken van kennisbankacties.
Qdrant
Qdrant is de vectordatabase waarin embeddings worden opgeslagen. Hierdoor kan het systeem informatie terugvinden op basis van inhoudelijke overeenkomst.
LiteLLM
LiteLLM abstraheert de koppeling naar modelaanbieders. Hierdoor kan de oplossing flexibel omgaan met verschillende LLM’s en embeddingmodellen zonder de bovenliggende architectuur sterk te hoeven aanpassen.
Interpretatie van het ontwerp
Het schema beschrijft een AI-architectuur die nadrukkelijk meer doet dan alleen chatten met een taalmodel. De opzet ondersteunt ook:
- Veilige toegang via SSO
- Opslag van gesprekken
- Documentinname
- RAG-achtige kennisbankfunctionaliteit
- Gebruik van interne en openbare informatiebronnen
- Gescheiden afhandeling van generatie en embeddings
Daarmee is dit een relatief volwassen en schaalbare architectuur voor een enterprise- of overheidscontext, waarin governance, bronverrijking en flexibiliteit in modelgebruik centraal staan.
Voor meer informatie over het opzetten van de ontwikkelomgeving, zie de Developer Mode documentatie.